近期,以OpenAI GPT-6 Astra為代表的通用多模態模型,展現出強大的跨本體、跨場景、跨任務通用互動能力,推動人工智慧加速邁向真實物理世界。大曉機器人透過深入分析發現,相比GPT-5.5,GPT-6 Astra的視覺空間錨定(Visual Grounding)準確率顯著提升,其強大的具身泛化能力不僅依賴高級推理,更得益於空間感知與空間推理能力的躍升。 在實際操作中,Astra透過Grounding精準識別目標物體、互動區域及空間參照,結合幾何計算確定位置、位移與運動參數,將抽象任務意圖轉化為具體物理動作。這一發現為具身智慧行業提供了重要技術啟示:以視覺空間錨定能力為關鍵突破口,加速推動具身智慧從高級認知邁向精準感知與可靠執行。
圍繞這一突破口,大曉機器人正式發布全新視覺空間錨定增強型具身基模型ACE-Brain-0.6。繼ACE-Brain-0.5探索感知、規劃、行動、評估與進化的統一認知閉環之後,ACE-Brain-0.6進一步聚焦Grounding這一核心能力,以GPT-6 Astra為重要參照,透過規模化、多樣化、可驗證的空間監督資料,強化模型的目標識別、空間定位與互動錨定能力,探索以資料Scaling驅動具身基模型能力躍升的新路徑,為提升通用具身互動能力提供關鍵支撐。
依託約百萬條高品質、可驗證的空間錨定訓練樣本,ACE-Brain-0.6實現具身空間感知能力新突破:在八項Grounding評測(七項國際權威公開基準及大曉自建RobotGrounding)中,六項成績超越OpenAI GPT-6 Astra;七項公開基準平均得分達74.53分,領先Astra的73.68分;在真實機器人場景評測RobotGrounding中取得94.13分,超越Astra的91.10分。同時,在與Google Gemini 4 Argon、Anthropic Claude Opus 5.5 以及阿里巴巴達摩院、北京智源研究院等國內外代表性模型的橫向對比中,ACE-Brain-0.6取得領先成績,充分展現出在物理空間理解與精準定位任務上的強勁競爭力。
此次突破的意義,不止於空間錨定能力超越GPT-6 Astra,更在於大曉機器人自主構建了一套規模化、自動化、可驗證的資料管線,探索並驗證了具身基模型能力進化的新路徑:透過多源資料融合、自動化空間標註與高品質監督資料構建,持續提升模型的物理空間感知能力。這不僅為具身基模型的高效訓練與能力擴展提供了可規模化的資料基礎,也為打通「語言理解—空間感知—物理行動」的關鍵鏈路提供了技術支撐,推動具身智慧從理解物理世界,向更加精準、可靠地作用於物理世界邁進。
從「看懂世界」到「找準目標」:具身物理智慧的能力進階
近期,以GPT-6 Astra為代表的通用多模態模型,正展現出廣泛的具身操作潛力;其能力不僅體現在複雜任務規劃與邏輯推理,更依賴於對物理場景中物體、位置及互動區域的精準感知。通用模型正從回答世界中的問題,走向嘗試對物理世界採取行動。
團隊分析了GPT-6 Astra執行機器人任務的過程。在放置水果籃的案例中,模型需識別籃筐邊緣與目標承載面,透過空間計算確定移動方向;在折疊T恤的案例中,則需提取衣物輪廓、估計尺寸並計算折疊距離。這揭示了一個關鍵事實:高級推理決定行動策略,而精準空間感知是將策略轉化為物理操作的基礎。
然而,即便是GPT-6 Astra,在細粒度幾何定位和複雜空間關係判斷方面仍存在局限。例如,尋找特定物體前方的空閒位置時,模型可能誤判至相鄰區域。對於文字問答,微小偏差或許無關緊要;但對於機器人,卻可能直接影響抓取、放置乃至整個操作鏈路的可靠性。
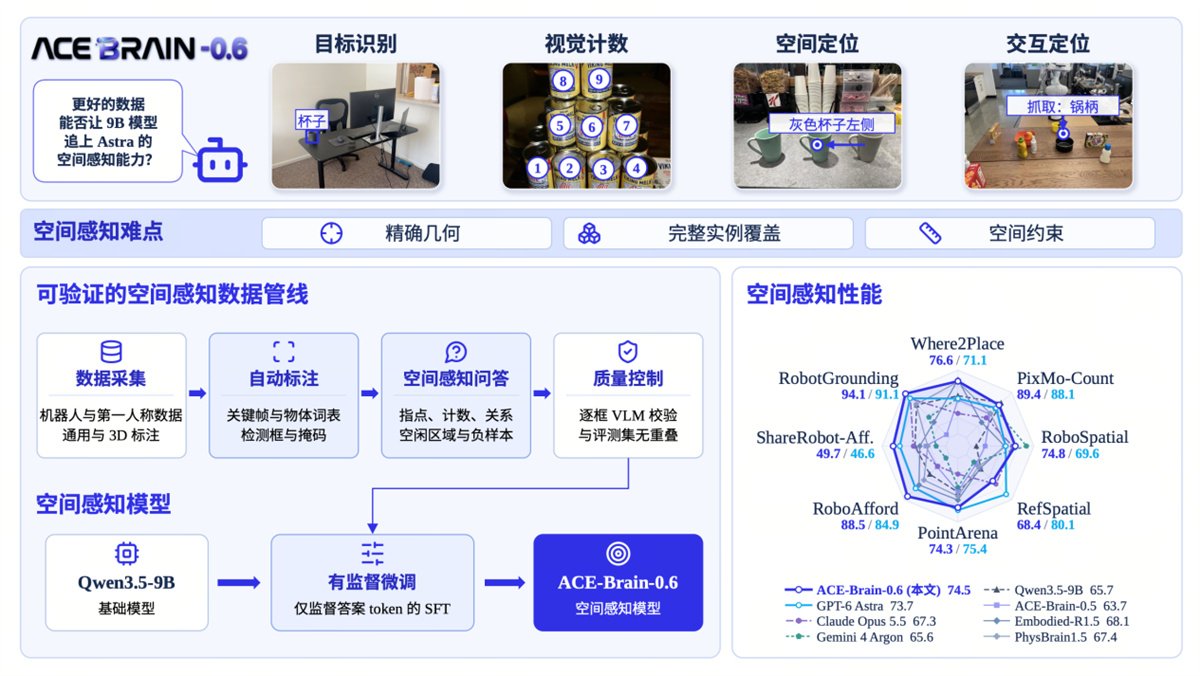
【ACE-Brain-0.6技術概覽圖】
基於此,ACE-Brain-0.6聚焦視覺空間錨定,將物體識別、多實例定位、空間關係理解、功能區域識別及互動位置預測整合為統一的空間感知能力體系,旨在回答能否透過高品質資料的規模化,讓一個9B模型在具身空間感知這一核心能力上達到甚至超越頂級通用模型。
9B模型挑戰頂級通用模型:六項Grounding評測超越GPT-6 Astra
ACE-Brain-0.6給出的答案,首先體現在一系列可量化的實驗結果中。團隊在八項Grounding評測上,對ACE-Brain-0.6與GPT-6 Astra、Claude Opus 5.5及多款開源具身模型進行了統一評估;測試覆蓋目標指代、視覺計數、空間定位、物體功能理解與互動區域預測等不同能力維度。
實驗顯示,ACE-Brain-0.6在八項Grounding評測中,有六項成績超越OpenAI GPT-6 Astra,包括Where2Place(76.55 vs. 71.10)、PixMo-Count(89.41 vs. 88.10)、RoboSpatial(74.82 vs. 69.55)、RoboAfford(88.51 vs. 84.94)、ShareRobot(49.70 vs. 46.60)以及RobotGrounding(94.13 vs. 91.10)。其中,在七項公開基準測試中,ACE-Brain-0.6以74.53分的綜合佳績領先GPT-6 Astra的73.68分,展現出其在具身空間理解、目標定位與互動區域識別等任務上的競爭力。
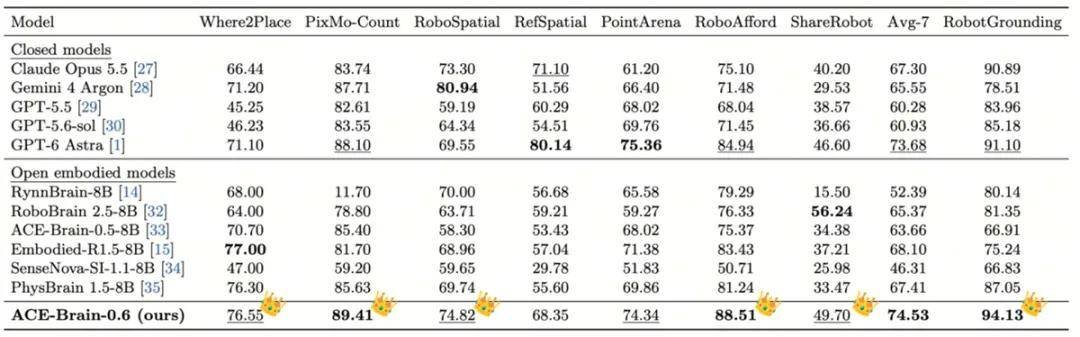
【ACE-Brain-0.6在八項Grounding評測中的六項超過GPT-6 Astra】
同時,ACE-Brain-0.6還在與Google Gemini 4 Argon、Anthropic Claude Opus 5.5,以及阿里巴巴達摩院、北京智源研究院等國內外代表性模型的對比中展現出領先優勢,進一步驗證了9B級模型透過高品質空間監督資料實現專項能力突破的技術潛力。
這些成績背後,反映出ACE-Brain-0.6在多種具身感知任務上的進步。它不僅能夠根據語言描述識別目標物體,還需要理解「哪裡能夠放置」「應該抓住哪個部位」「哪些物體滿足指定條件」等更具操作意義的問題。尤其在物體功能區域和空間可供性(Affordance)相關評測中,模型展現出較強的細粒度定位表現。
為了進一步檢驗模型對真實機器人場景的適應能力,團隊還構建了RobotGrounding評測集,包含2591道問題,覆蓋14類任務,包括目標定位、小物體識別、多實例計數、目標缺失判斷及跨相機視角對應等。ACE-Brain-0.6取得94.13分,領先GPT-6 Astra約3.03分,也高於參與比較的其他模型。
尤其值得關注的是,模型對「不存在的目標」的識別能力顯著提升。當使用者要求機器人尋找場景中並不存在物品時,模型需要準確判斷目標缺失,而不是生成一個看似合理卻實際錯誤的位置。在真實操作中,這種能力同樣重要:機器人不僅要知道該對什麼行動,也要知道什麼時候不應貿然行動。
上述結果不僅展現了ACE-Brain-0.6在空間錨定基準上的領先表現,更揭示了具身智慧基礎能力演進的重要方向:在直接決定物理操作精度與可靠性的關鍵感知環節,透過高品質資料驅動與針對性能力強化,9B級模型同樣能夠突破參數規模限制,形成比肩甚至超越頂級通用模型的專業能力,為構建高效、精準、可泛化的具身智慧系統開闢新路徑。
百萬條訓練樣本:讓機器人資料真正轉化為具身感知能力
ACE-Brain-0.6的另一項核心貢獻,是建立了一套面向具身空間理解的統一資料構建流程。不同於網際網路圖文資料,機器人互動資料雖包含連續視覺觀測、動作軌跡與任務指令,卻缺乏細粒度的物體位置、功能區域和空間關係標註。機器人記錄了大量「做過什麼」,模型卻未必理解「為什麼選擇這個目標」「動作應該發生在哪裡」。為此,大曉機器人整合了30餘個開源機器人資料家族和私有Ego資料,融合人類第一視角互動、物體與部件密集標註及三維空間資料,將異構資料統一轉化為可驗證的空間錨定監督訊號。
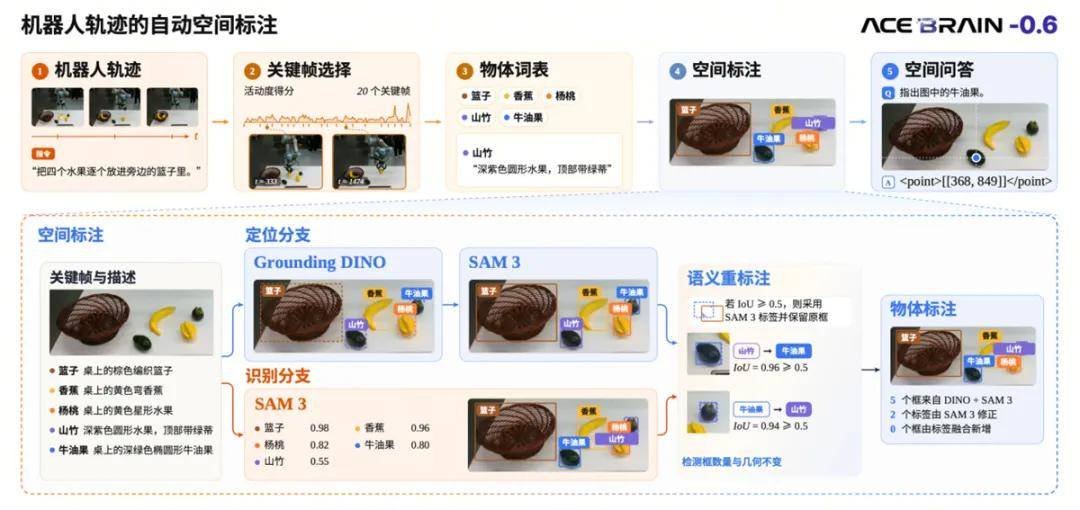
【ACE-Brain-0.6的機器人運動軌跡的自動化空間標註】
針對機器人操作影片,系統依據夾爪狀態與動作幅度篩選關鍵幀,自動構建場景物體詞彙表,並結合Grounding DINO、SAM 3等視覺工具完成物體定位、區域識別和語義校正,進一步生成目標指代、計數、空間關係、互動位置及目標不存在判斷等多類型問答資料。
關鍵不只是資料規模,更在於每個訓練答案都具有明確、可核驗的視覺依據。例如,只有物體實例標註完整時,才生成目標計數問題;對於目標不存在的提問,則需驗證其確實未出現在畫面中。同時,透過標註校驗、答案均衡及評測資料排除等機制,減少錯誤監督與訓練捷徑的干擾。
最終,團隊構建了約百萬條訓練樣本,涉及約94萬張不同圖像和270萬組問答對。模型基於Qwen3.5-9B,凍結視覺編碼器,對語言模型參數進行監督微調,並透過統一介面完成空間座標、目標區域、計數及判斷結果的預測。由此,原本記錄操作過程的資料,進一步轉化為模型可學習的空間知識。從「記錄物理互動」到「理解互動對象與位置」,資料正成為連接機器人經驗與具身基模型能力的重要橋樑。
資料規模化的價值:從堆積樣本走向擴展能力邊界
更值得關注的是,ACE-Brain-0.6透過受控實驗,進一步揭示了空間錨定能力隨資料規模增長的變化規律。在保持模型架構與訓練方法不變的條件下,團隊將訓練資料從26萬條逐步擴展至百萬條,七項公開評測的平均得分由69.3分提升至74.5分,呈現近似對數線性的增長趨勢。訓練資料規模每翻倍,綜合得分平均提升約2.4分,最終超越GPT-6 Astra。 但研究也發現,單純增加已有資料類型的樣本,效能提升不足1分;真正驅動能力增長的,是持續引入新場景、新空間關係及多樣化監督形式,拓展模型的空間理解邊界。
這一發現揭示了具身智慧能力進化的重要路徑:面對物理世界中複雜多變的物體、視角與互動需求,模型需要的不只是更多資料,更是覆蓋廣泛、資訊豐富且可驗證的空間知識。ACE-Brain-0.6證明,透過持續拓展資料覆蓋與監督維度,即使模型架構與參數規模保持不變,也能推動空間感知能力持續進化。 這進一步凸顯了高品質資料、資訊密度與自動化資料構建體系在具身基礎模型規模化發展中的核心價值。
從空間錨定到物理智慧:讓每一次推理都找到現實落點
ACE-Brain-0.6揭示了具身物理智慧發展的重要方向:空間錨定不僅要回答「目標在哪裡」,更要理解「這個位置為什麼能夠支持行動」。 從視覺座標到空間約束,從物體定位到互動可行性,模型需要持續吸收更豐富的物理監督訊號,推動空間感知從精準識別邁向行動理解。
作為連接高級任務推理與底層物理執行的關鍵環節,空間錨定是機器人實現自主操作的重要能力基礎。無論是零售分揀、物流操作還是服務機器人,精準識別目標、定位抓取區域與理解放置空間,都是實現可靠執行的前提。這也與大曉機器人堅持的資料、模型與真實場景協同研發方向高度契合,持續推動物理資訊向模型能力轉化。
此次ACE-Brain-0.6以9B級模型在6項Grounding評測中超越GPT-6 Astra,驗證了高品質Grounding資料規模化的技術潛力。 從看見世界到找準目標,從理解指令到錨定行動,大曉機器人正持續推動模型認知與真實物理世界精準連接,加速具身智慧從抽象理解走向可靠、可執行的物理智慧。


